熱區分析
核密度估計的半徑、
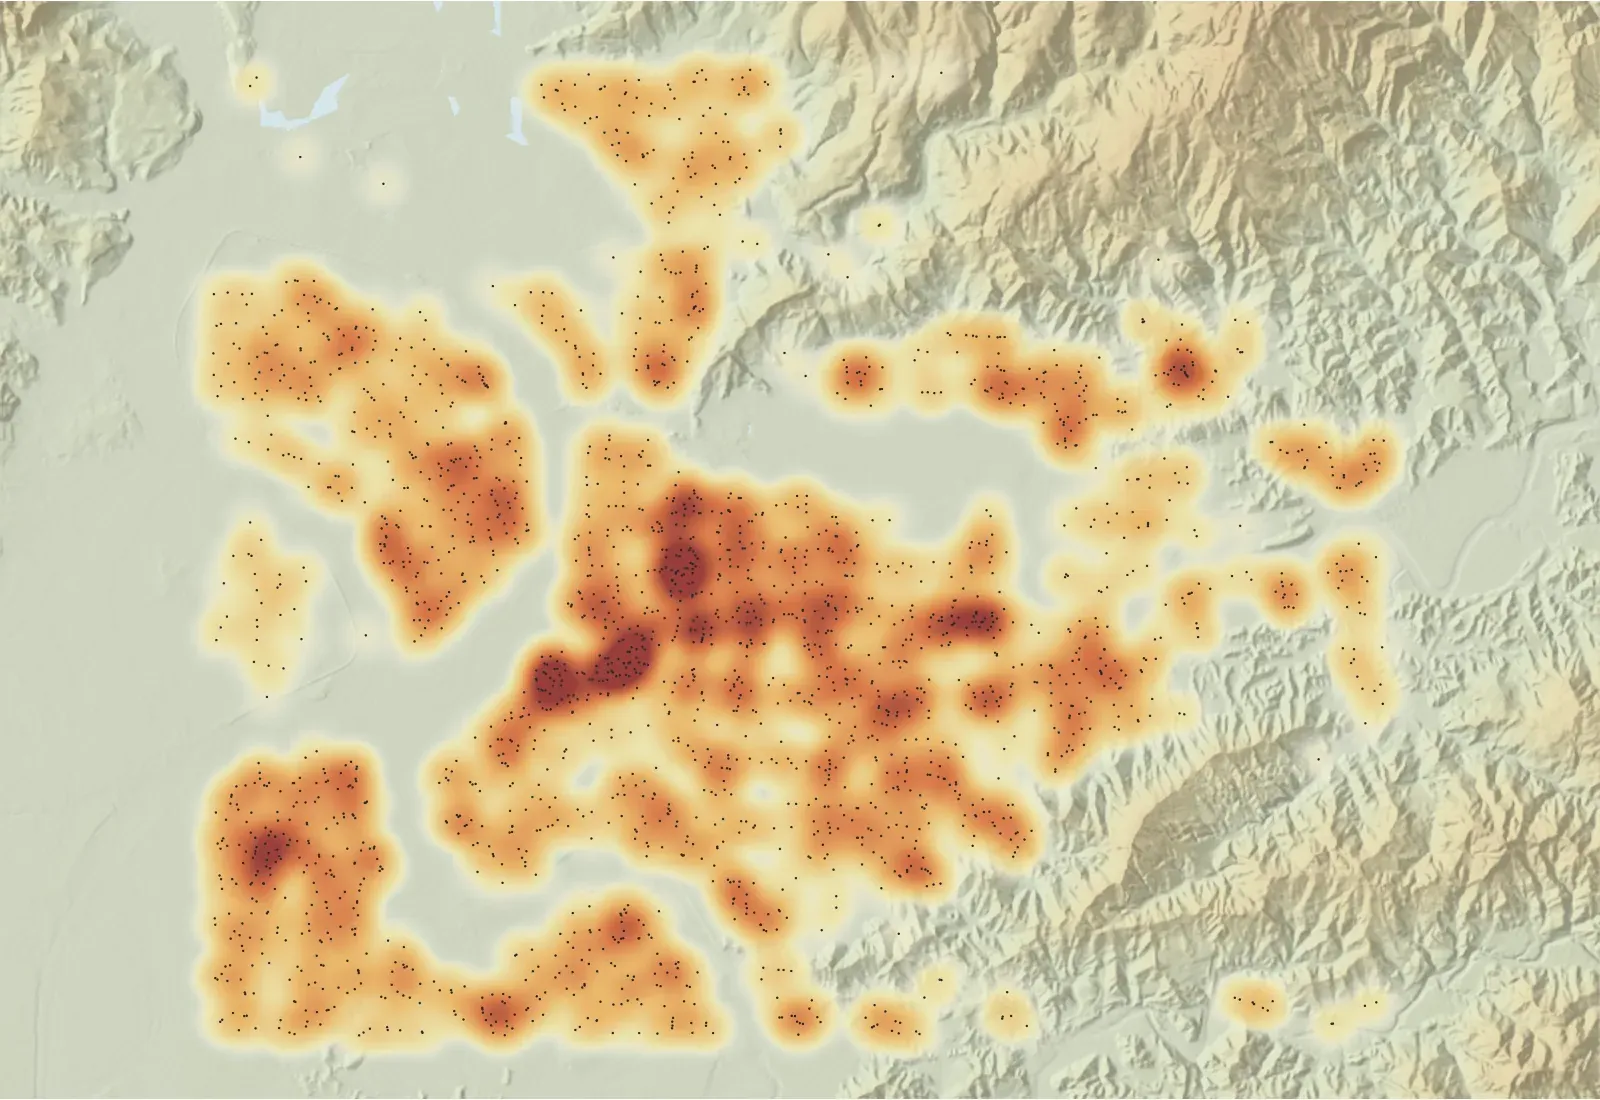
臺北盆地
- 密度 0–58 家/平方公里
- 便利商店(OSM shop=convenience)
交通事故點、災害通報點、崩塌點、路燈報修點,數量一多,點圖就變成一片糊,看不出哪裡集中。熱區圖(核密度估計,Kernel Density Estimation,KDE)把點轉成一張連續的密度柵格,讓「集中在哪裡」一眼看得出來。
但熱區圖也是最容易誤導的地圖之一:
- 同一份資料,半徑設 200 公尺是十幾個小熱點,設 2 公里變成一整片紅
- 輸出是一片均勻的顏色,或只有一個像元大小的亮點
- 熱區剛好都在人口多、道路多的地方,看不出是不是真的「比較危險」
- 跑一次要很久,檔案大到幾 GB
這些都和半徑、像元大小、坐標單位,以及「密度」本身的意義有關。
| 圖層 | 幾何 | 用途 | 取得方式 |
|---|---|---|---|
| 事件點 | 點 | 要估計密度的事件 | 自有資料;或於 政府資料開放平臺 搜尋交通事故等含坐標的資料集 |
| 研究範圍 | 多邊形 | 決定輸出範圍、裁掉海面與範圍外 | 行政界,data.gov.tw 下載 |
| (選用)權重欄位 | 點的數值欄位 | 例如傷亡人數、損失金額 | 原始資料欄位 |
點圖層必須在以公尺為單位的投影坐標系(建議 EPSG:3826)。下載的 CSV 若是經緯度,先以 圖層 Layer ▸ 加入圖層 Add Layer ▸ 加入分隔文字圖層 Add Delimited Text Layer 載入為 EPSG:4326,再重新投影存成新檔。
操作步驟(QGIS 4)
Section titled “操作步驟(QGIS 4)”-
先看點的分布尺度:向量 Vector ▸ 分析工具 Analysis Tools ▸ 最近鄰分析 Nearest neighbour analysis,記下報告裡的觀測平均距離(observed mean distance)。它可以當作半徑的起點參考(見「原理」)。
-
處理工具箱 ▸ 內插 Interpolation ▸ 熱區圖(核密度估計)Heatmap (Kernel Density Estimation)。
- 點圖層 Point layer:事件點
- 半徑 Radius:預設
100,單位是圖層坐標系的單位(EPSG:3826 下為公尺)。先用一個你能說出理由的值,例如500 - 輸出點陣大小 Output raster size:像元大小 Pixel size X/Y 預設
0.1,在公尺坐標下是 10 公分,幾乎一定太小,改成半徑的 1/5~1/10 左右,例如半徑 500 公尺用50(理由見「原理」) - 進階參數 權重欄位 Weight from field:要以傷亡人數加權時選這裡
- 進階參數 核函數形狀 Kernel shape:預設 Quartic,先不改
- 進階參數 輸出值縮放 Output value scaling:預設 Raw
-
執行後在圖層屬性 ▸ 符號 Symbology 改用單波段假色 Singleband pseudocolor,色帶選由透明到暖色的漸層,並把最小值以下設為透明,熱區才不會蓋掉底圖。
-
用研究範圍裁掉範圍外:點陣 Raster ▸ 擷取 Extraction ▸ 依遮罩圖層裁切點陣 Clip Raster by Mask Layer。
-
換兩個半徑(例如一半與兩倍)各再跑一次,三張圖並排比較。熱區位置穩定的才是可以寫進報告的熱區。
KDE 在算什麼
Section titled “KDE 在算什麼”每個點放一個「小山丘」(核函數),山丘的半徑就是 Radius,中心最高、往外遞減到半徑處為零。所有點的小山丘疊加起來,就是密度面。某個像元的值越高,代表它附近一定半徑內的點越多、越近。
單一點的核函數(剖面)          多點疊加
      ▲                          ▲     ╱╲     ╱ ╲                         │    ╱  ╲╱╲    ╱   ╲                        │   ╱      ╲───╱─────╲───                ────┴──╱────────╲──   ←  r  →                      點 點 點    點
半徑:最主要的參數
Section titled “半徑:最主要的參數”官方文件的描述是:半徑決定一個點的影響範圍,數值越大越平滑,數值越小越能看出細部變化。實務上的意義是:
- 半徑太小:每個點自己一個小圓,看起來就像點圖換了顏色,沒有「集中」的資訊。
- 半徑太大:所有東西融成一大片,熱區的位置被往人口重心拉。
- 半徑應該對應問題的空間尺度:「哪個路口事故多」是幾十到一兩百公尺;「哪個生活圈事故多」是公里級。
QGIS 不會替你決定半徑。最近鄰平均距離可以當作下限參考:半徑小於它,大部分點的山丘不會互相重疊。選定後在報告寫明半徑與理由,並附上一組敏感度比較(步驟 5)。
半徑來自欄位 Radius from field 可以讓每個點用不同半徑,例如依事件規模給不同影響範圍;沒有明確理由時不要用,會讓結果很難解釋。
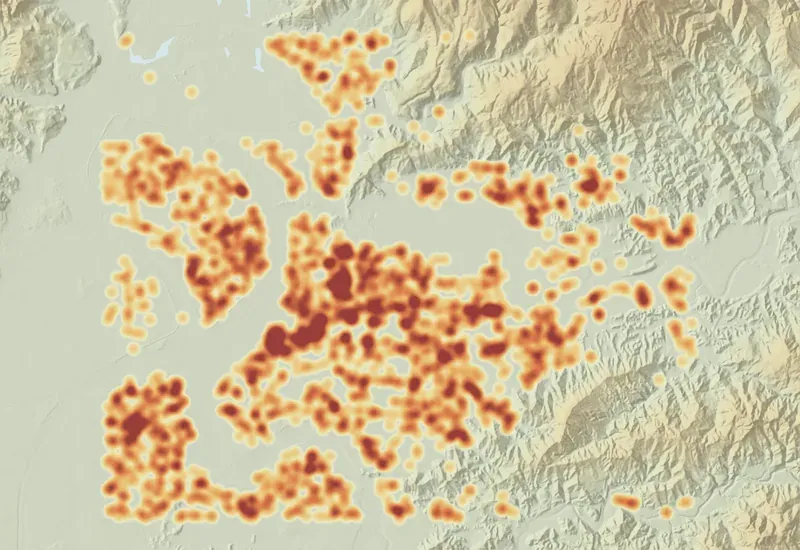
半徑 250 公尺
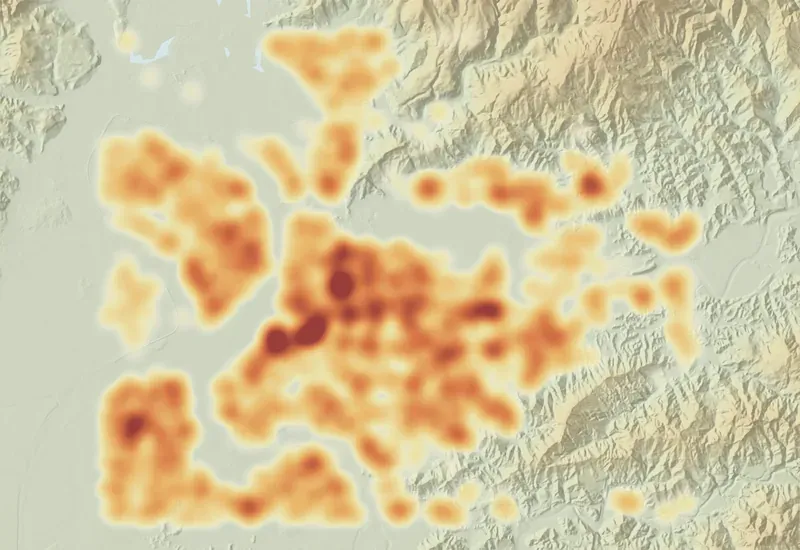
半徑 500 公尺
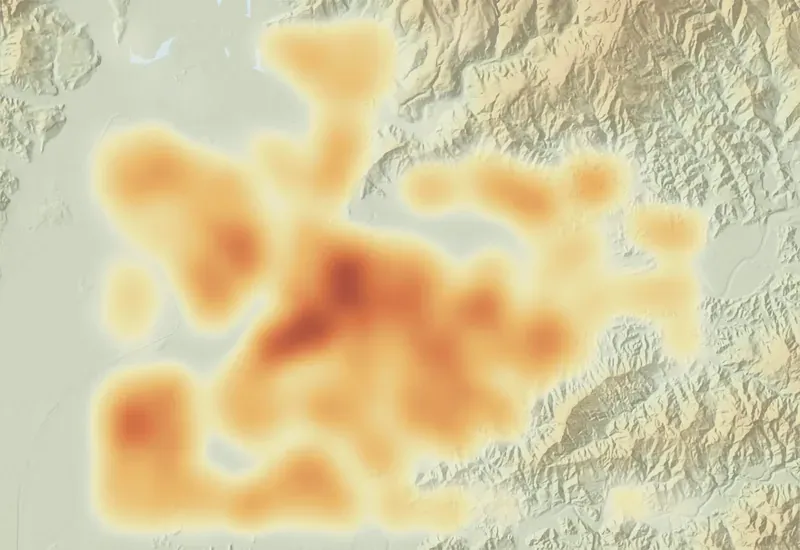
半徑 1000 公尺
像元大小:解析度和檔案大小的取捨
Section titled “像元大小:解析度和檔案大小的取捨”像元大小決定輸出柵格有多細。它不影響「密度怎麼算」,只影響「多細地取樣」:
- 像元遠小於半徑:曲面平滑,但檔案很大、很慢。預設的
0.1在公尺坐標下會在大範圍產生天文數字的像元數。 - 像元接近或大於半徑:每個山丘只被一兩格取樣,熱區變成方塊,位置也會偏。
- 半徑的 1/5~1/10 是常用的折衷,屬經驗值,不是規範,可依出圖比例尺調整。
權重:密度變成「強度」
Section titled “權重:密度變成「強度」”指定 Weight from field 後,每個點的山丘高度乘上權重。用傷亡人數加權,熱區表示「傷亡集中處」而不是「事故件數集中處」,兩張圖要回答的問題不同,圖名與圖例要寫清楚。權重欄位有空值或負值時要先清理。
核函數形狀與衰減
Section titled “核函數形狀與衰減”| 核函數 Kernel shape | 特性 |
|---|---|
| Quartic(預設) | 平滑遞減,最常用 |
| Triangular | 線性遞減;可搭配 衰減比 Decay ratio 調整 |
| Uniform | 半徑內權重相同,邊緣陡降 |
| Triweight | 官方文件說明熱點較「銳利」 |
| Epanechnikov | 官方文件說明熱點較「平滑」 |
Decay ratio 只對 Triangular 有效:0 表示中心最強、邊緣為零;1 等同 Uniform;大於 1 則邊緣比中心強。實務上核函數形狀的影響遠小於半徑,先把半徑定好,核函數維持預設即可。
輸出值的單位
Section titled “輸出值的單位”Output value scaling 有 Raw 與 Scaled 兩種。官方文件沒有說明兩者的數值定義,所以不要把熱區圖的像元值寫成「每平方公里幾件」,除非你另外驗證過換算方式。熱區圖適合用來比較相對高低,圖例用「低/高」或分位數即可。
熱區不等於風險
Section titled “熱區不等於風險”事故密度高的地方,往往只是車流量、人口最多的地方。熱區圖呈現的是「事件集中」,不是「單位暴露量下的風險」。要談風險,需要把事件數除以暴露量(例如車流量、人口),這通常要先做 06 網格彙總,在同一組網格上算比率。
研究範圍邊緣(海岸、縣界)外面沒有資料,靠邊的點只有一半的山丘落在範圍內,邊緣的密度會被低估。範圍外其實有事件、只是沒取得時,要在報告裡說明;能取得的話,資料範圍要比出圖範圍大至少一個半徑。
| 症狀 | 原因 | 解法 |
|---|---|---|
| 執行很久、檔案極大 | 像元大小用預設的 0.1 |
改成半徑的 1/5~1/10 |
| 整張圖一片均勻 | 半徑太大,或點圖層是經緯度、半徑被當成度 | 確認 CRS 為 EPSG:3826,縮小半徑 |
| 只有零星小亮點 | 半徑太小,或像元大於半徑 | 參考最近鄰平均距離加大半徑;縮小像元 |
| 熱區呈方塊狀 | 像元太大 | 縮小像元大小 |
| 熱區都在市中心 | 呈現的是事件數,未考慮暴露量 | 改做比率分析,或在圖說註明 |
| 熱區蓋住底圖看不到街道 | 低值未設透明 | 符號設定把最低級距設為透明,或調整圖層透明度 |

- 用同一份事件點,半徑分別設 250、500、1,000 公尺(像元固定 50 公尺)做三張熱區圖。
- 檢查方式:三張圖中都出現的熱點才算穩定熱區;列出這些熱點,並說明半徑 1,000 公尺時哪些小熱點被合併了。
- 半徑固定 500 公尺,像元分別設 10、50、250 公尺。
- 檢查方式:記錄每次的執行時間與檔案大小;250 公尺時熱區形狀應明顯呈方塊、位置偏移。
- 有權重欄位時,加權與不加權各做一張。
- 檢查方式:找出兩張圖排名差最多的熱區,回頭查那裡的點,應是件數少但權重大(或相反)的地點。
- QGIS 官方文件:Interpolation(Heatmap (Kernel Density Estimation)):半徑、像元大小、核函數、衰減比的預設值與說明皆出自此頁
- QGIS 官方文件:Vector analysis(Nearest neighbour analysis)
- 「像元約為半徑 1/5~1/10」為經驗值,非官方建議。